Resumen
Cómo agrupar, correlacionar y suprimir notificaciones repetidas sin perder evidencia ni ocultar incidentes en una cartera WordPress.
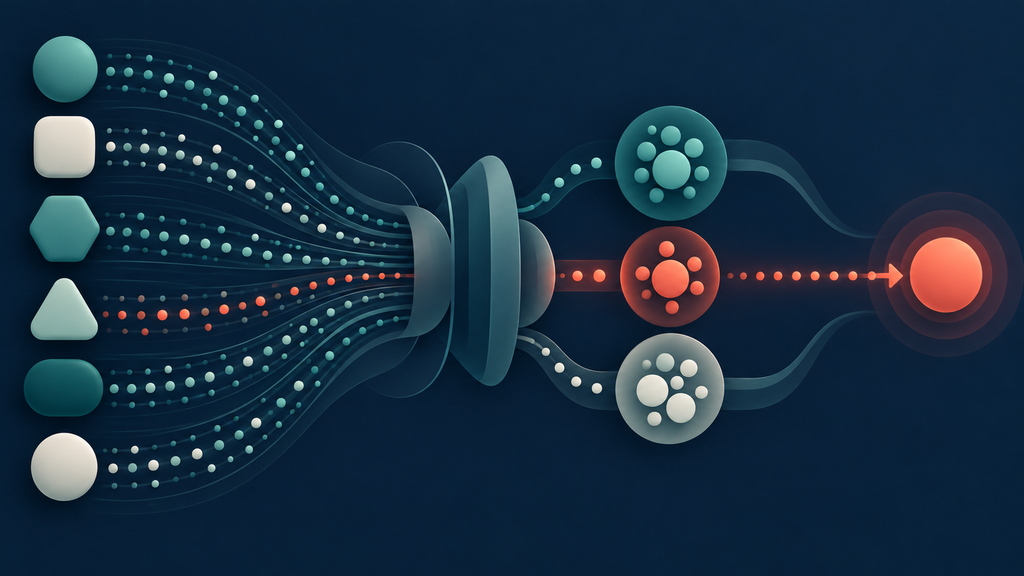
Respuesta corta: para reducir el ruido de alertas WordPress sin ocultar incidentes, una agencia debe agrupar repeticiones, añadir contexto y suprimir notificaciones, no evidencias. La regla práctica es sencilla: conserva cada evento verificable, reúne los que pertenecen al mismo patrón y avisa a una persona solo cuando cambia la decisión, la prioridad, el alcance o el estado del caso.
Esta guía está pensada para agencias, freelancers y equipos que monitorizan varios WordPress. OWASP sustenta los principios de registro proporcional, contexto, correlación, verificación y escalado. El modelo operativo, los campos y los umbrales que siguen son una propuesta editorial de WSN/Vulnity: deben probarse con la cartera real y no sustituyen un análisis de riesgo.
Publicado y revisado el 18 de septiembre de 2026.
El objetivo no es recibir menos datos, sino interrumpir menos al equipo
Un ataque de fuerza bruta puede generar cientos de fallos de acceso. Una actualización programada puede producir cambios legítimos en varios sitios. Una caída del canal de telemetría puede dejar una web en silencio. Si cada evento crea un correo o un ticket independiente, el volumen crece más rápido que la capacidad de investigar.
La Logging Cheat Sheet de OWASP indica que el registro debe definirse según el riesgo y advierte que una lista ciega puede crear una «niebla de alarmas» en la que los problemas reales pasan inadvertidos. También recomienda registrar éxitos y fallos de autenticación, fallos de autorización, acciones administrativas y cambios de configuración con contexto suficiente para investigarlos.
La categoría A09:2025 de OWASP añade una consecuencia operativa: demasiados falsos positivos pueden hacer que las alertas importantes se reconozcan tarde o no se reconozcan. También considera deficientes los umbrales ineficaces, los procesos de escalado incompletos y las alertas que no se reciben o revisan a tiempo.
Juicio editorial: reducir ruido no significa borrar eventos hasta que el panel parezca limpio. Significa separar tres capas: el evento que debe conservarse, el caso que debe investigarse y la notificación que merece interrumpir a alguien.
Tres objetos distintos: evento, caso y notificación
| Objeto | Qué representa | Qué debe conservar | Error habitual |
|---|---|---|---|
| Evento | Una observación concreta en una fuente y momento. | Sitio, hora de origen y recepción, actor, acción, resultado, fuente e identificador. | Descartarlo porque se parece a otro y perder alcance o cronología. |
| Caso | El conjunto de eventos que exige una misma decisión o investigación. | Eventos vinculados, hipótesis, prioridad, propietario, acciones y evidencia de cierre. | Abrir un ticket por cada repetición o mezclar patrones no relacionados. |
| Notificación | La interrupción enviada a una persona o canal. | Qué cambió, por qué importa, alcance, prioridad y acción esperada. | Reenviar continuamente el mismo estado sin nueva información. |
La supresión segura se aplica a la notificación repetida, no al evento fuente. Si cien intentos contra una cuenta se convierten en un solo caso, el caso debería seguir mostrando el total, la ventana temporal, las IP o redes implicadas y los sitios afectados. Un resumen sin trazabilidad solo cambia ruido por opacidad.
Qué contexto permite agrupar alertas WordPress
OWASP recomienda registrar atributos como la hora del evento y del registro, un identificador de interacción, la aplicación, la dirección de origen, la identidad conocida, el tipo, la severidad y el resultado. No todos esos campos estarán disponibles en cada WordPress, pero constituyen una buena base para decidir qué eventos pertenecen al mismo patrón.
Para una cartera multi-sitio, un esquema mínimo útil incluye:
- sitio y entorno: producción, staging o desarrollo;
- fuente: WordPress, plugin de seguridad, hosting, proxy, WAF o proveedor de identidad;
- actor: usuario, IP, sesión o integración cuando se conozca;
- acción y resultado: acceso fallido, acceso correcto, cambio de rol, alta de administrador, bloqueo o error;
- tiempo: hora de origen y hora de recepción, sin asumir que son iguales;
- alcance: cuenta, sitio, grupo de clientes o integración compartida;
- identificador estable: evento o interacción que permita volver a la evidencia.
No agrupes únicamente por texto del mensaje. Dos alertas con el mismo título pueden afectar a sitios, cuentas o ventanas distintas. Y dos mensajes diferentes pueden describir una sola campaña cuando comparten actor, objetivo, secuencia y tiempo.
Un flujo de seis pasos para reducir ruido con seguridad
1. Normaliza antes de deduplicar
Convierte las fuentes a un vocabulario común sin borrar el original. Por ejemplo, conserva el mensaje del proveedor y añade campos comparables como authentication_failure, admin_user_created o configuration_changed. La normalización permite comparar; la evidencia original permite comprobar.
2. Define una clave de agrupación explícita
Una clave puede combinar tipo de evento, sitio, cuenta, origen y una ventana temporal. Debe estar documentada y ser reversible: el analista tiene que poder ver por qué dos eventos acabaron en el mismo caso. Evita claves tan amplias como «todos los fallos de acceso del día».
3. Mantén contadores y diversidad
No basta con decir «evento repetido». Registra cuántas veces ocurrió, cuándo empezó, cuándo se vio por última vez y qué diversidad existe: IP, usuario, sitio o país cuando esa información sea lícita y fiable. Un volumen estable en una web no equivale a un patrón que aparece simultáneamente en veinte clientes.
4. Notifica cambios materiales
Una nueva notificación está justificada cuando aparece un sitio o una cuenta privilegiada adicional, aumenta la prioridad, se confirma un acceso correcto después de varios fallos, cambia el patrón, fracasa una contención o vence el tiempo de respuesta. Repetir «sigue ocurriendo» cada minuto rara vez mejora la decisión.
5. Limita toda supresión
Cada regla necesita propietario, alcance, fecha de revisión y condición de salida. Una ventana de mantenimiento debe expirar. Una fuente confiable puede cambiar. Una IP interna puede dejar de serlo. Las excepciones permanentes y sin dueño convierten el sistema de reducción de ruido en un punto ciego.
6. Verifica con señales controladas
OWASP recomienda comprobar que el registro funciona como se especificó, que los eventos se clasifican de forma coherente y que el sistema responde a fallos de conectividad, espacio, permisos o del propio mecanismo. También pide procesos para detectar cuándo el logging se ha detenido.
Prueba el flujo con una señal segura en varios sitios: confirma que los eventos se conservan, que las repeticiones forman un caso, que un cambio de alcance genera una nueva notificación y que la ausencia de una fuente no se interpreta como ausencia de actividad.
Matriz práctica: agrupar, resumir, silenciar o escalar
| Situación | Tratamiento recomendado | Condición de seguridad |
|---|---|---|
| Muchos fallos de acceso al mismo usuario y sitio en pocos minutos. | Agrupar en un caso con contador, ventana y diversidad de origen. | Escalar si aparece un acceso correcto, privilegio alto o más sitios. |
| La misma campaña golpea varias webs. | Correlacionar a nivel de cartera y conservar el detalle por sitio. | No ocultar qué clientes están afectados ni qué sitios dejaron de comunicar. |
| Cambios esperados durante un mantenimiento aprobado. | Reducir notificaciones dentro de una ventana limitada. | Conservar eventos, responsable, alcance y fin automático de la excepción. |
| Regla repetidamente falsa por mala configuración. | Corregir la fuente o el umbral; no silenciar indefinidamente. | Probar después la señal y documentar qué riesgo sigue sin cubrir. |
| Alta o cambio de una cuenta administrativa. | Notificar de forma independiente o elevar el caso relacionado. | No suprimir por volumen: el cambio de privilegio altera la decisión. |
| Un sitio deja de enviar datos. | Abrir un problema de cobertura. | No marcarlo como «sin alertas»; su estado es «no observado». |
Cinco guardarraíles que evitan ocultar incidentes
- Nunca pierdas el evento fuente. El resumen debe enlazar a la evidencia o conservar su identificador.
- No suprimas cambios de privilegio, éxito o alcance. Un acceso correcto después de fallos, un nuevo administrador o un segundo sitio pueden cambiar por completo la prioridad.
- Separa silencio esperado de fuente ausente. La guía sobre huecos de monitorización en una cartera WordPress explica por qué una web sin telemetría no puede tratarse como una web sin actividad.
- Haz expirar excepciones y mantenimientos. Toda regla temporal necesita una fecha o evento de salida.
- Mide reaperturas y alertas tardías. Si los casos se reabren o una señal crítica aparece después del cierre, la agrupación o el criterio de cierre necesita revisión.
Cómo medir si realmente has reducido ruido
No uses solo «número de alertas». Un descenso puede significar mejor correlación o una fuente rota. Mide por separado:
- eventos recibidos, casos abiertos y notificaciones enviadas;
- porcentaje de casos con eventos trazables;
- media y percentil 90 de repeticiones por caso;
- casos que cambiaron de prioridad y motivo;
- reglas de supresión activas, caducadas y sin propietario;
- falsos positivos confirmados y falsos negativos detectados en pruebas;
- casos reabiertos por agrupación o cierre incorrectos;
- sitios con cobertura fresca frente al total esperado.
Relaciona estas métricas con el SLA de respuesta a alertas WordPress. Reducir notificaciones solo es una mejora si el equipo valida antes las señales importantes y mantiene la trazabilidad necesaria para cerrar con evidencia.
Dónde encaja Vulnity y cuáles son sus límites
Vulnity centraliza la seguridad de varios WordPress con alertas en tiempo real, monitorización de actividad sospechosa, bloqueo automático de IPs maliciosas e informes profesionales. Una vista común reduce el salto entre paneles y facilita comparar sitios, priorizar y aplicar un proceso consistente.
Eso no demuestra por sí solo que una regla agrupe correctamente, que una excepción sea segura o que una alerta pueda cerrarse. Vulnity no detecta CVEs ni identifica plugins, temas o versiones de WordPress vulnerables. Tampoco sustituye un WAF, un escáner de malware, los logs del hosting, backups probados, gestión de identidad, recuperación o análisis forense.
Conclusión: conserva evidencia y reduce interrupciones
Una buena operación no convierte cada evento en una alarma ni cada silencio en tranquilidad. Conserva los datos que permiten reconstruir lo ocurrido, agrupa lo que exige la misma decisión y notifica solo cuando cambia algo material.
Empieza con dos o tres patrones frecuentes, una clave de agrupación explícita y una ventana corta. Prueba éxitos, cambios de privilegio, ampliación a otro sitio y pérdida de telemetría. Si el resumen no permite volver a cada evento o una excepción no tiene fin, todavía no has reducido ruido de forma segura: solo lo has escondido.
Centraliza la operación, conserva la evidencia y reserva las interrupciones para cambios que exigen una decisión.
Conoce Vulnity para gestionar la seguridad de varios WordPress desde una vista común →
Sobre Vulnity
Mantener WordPress seguro requiere visibilidad operativa continua. Vulnity ayuda a monitorizar actividad sospechosa, alertar de cambios relevantes y conservar evidencias de respuesta.