Resumen
Un playbook práctico para clasificar, contener, recuperar y cerrar incidentes WordPress con responsables, evidencia y límites claros.
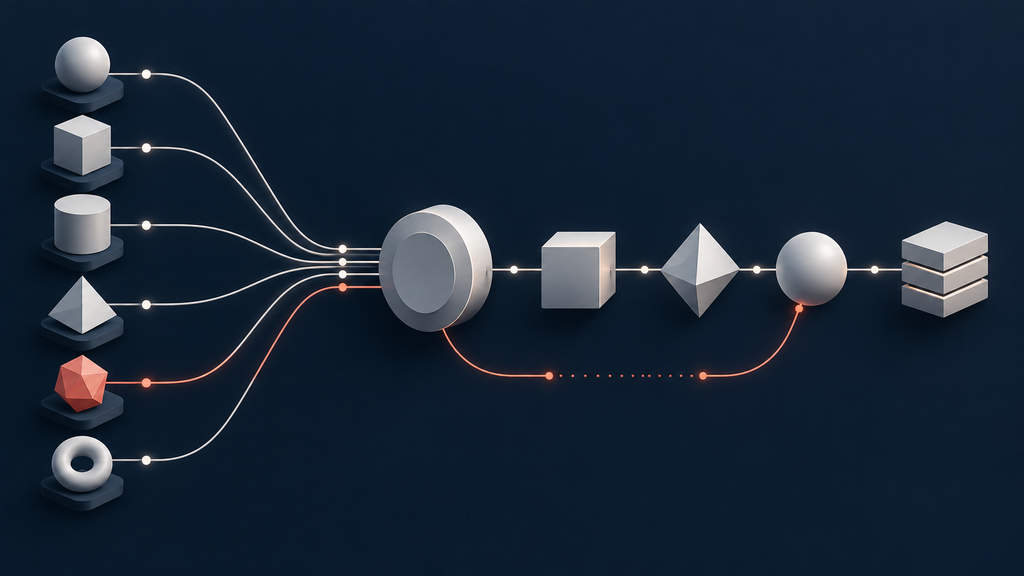
Respuesta corta: un playbook de incidentes WordPress para una agencia debe fijar antes de la urgencia quién decide, qué evidencia se conserva, cómo se delimita el alcance, qué acciones requieren aprobación y qué prueba permite volver a operar. No es una lista genérica de limpieza: es un contrato operativo repetible para responder de forma coherente en varias webs sin destruir pruebas ni improvisar con el cliente esperando.
Este modelo está pensado para agencias, freelancers y equipos de mantenimiento que administran una cartera WordPress. Sirve para organizar la respuesta; no sustituye a un especialista forense, al hosting, al proveedor de identidad ni a las obligaciones legales que puedan existir. Publicado y revisado el 25 de septiembre de 2026.
Qué problema resuelve un playbook
Una alerta no se convierte sola en una respuesta. Entre detectar algo extraño y cerrar el caso hay decisiones sobre alcance, continuidad, credenciales, copias, comunicación y riesgo residual. Si cada técnico resuelve esas decisiones de memoria, dos incidentes parecidos pueden acabar con acciones incompatibles: borrar antes de conservar evidencia, restaurar una copia sin conocer su fecha de compromiso o comunicar «resuelto» cuando solo se ha actualizado un componente.
NIST SP 800-61 Rev. 3, publicado como versión final en abril de 2025, integra la respuesta a incidentes en la gestión del riesgo y busca mejorar la preparación, la detección, la respuesta y la recuperación. Esa es la evidencia general. La adaptación a una cartera WordPress —sus roles, puertas de aprobación y criterios de cierre— es la propuesta editorial de este artículo.
Los ocho campos que debe definir antes del incidente
| Campo | Decisión que debe dejar resuelta | Fallo que evita |
|---|---|---|
| Alcance | Qué sitios, hosting, DNS, correo, CDN y cuentas entran en el servicio. | Descubrir durante el incidente que nadie tiene acceso a una dependencia crítica. |
| Clasificación | Qué convierte una alerta en evento, incidente probable o incidente confirmado. | Tratar todo como emergencia o normalizar señales graves. |
| Responsables | Quién coordina, quién ejecuta, quién aprueba y quién informa al cliente. | Órdenes contradictorias y esperas sin propietario. |
| Evidencia mínima | Qué datos se preservan antes de cambiar usuarios, archivos, reglas o credenciales. | Perder la secuencia necesaria para entender alcance y causa. |
| Contención | Qué acciones son reversibles, cuáles interrumpen servicio y quién las autoriza. | Convertir una medida de seguridad en una caída innecesaria. |
| Recuperación | Qué copia, versión y configuración pueden restaurarse y cómo se validan. | Reintroducir el problema o aceptar una restauración incompleta. |
| Comunicación | Qué se comunica, cuándo, por qué canal y con qué grado de certeza. | Prometer una resolución sin evidencia o exponer datos sensibles. |
| Cierre | Qué pruebas permiten cerrar y qué riesgo residual queda abierto. | Confundir «acción realizada» con «incidente resuelto». |
Un flujo práctico en siete fases
1. Recibe la señal y protege el contexto
Registra la hora de detección, el sitio, la fuente, el comportamiento observado y quién recibió la alerta. Conserva la notificación original y evita reescribirla como una conclusión. «Nuevo administrador a las 03:14» es un hecho observado; «la web está comprometida» todavía puede ser una hipótesis.
OWASP recomienda que los registros incluyan contexto del evento —cuándo, dónde, quién y qué ocurrió— y que la salida del sistema de monitorización se integre con los procesos de respuesta. También advierte que no deben registrarse secretos como contraseñas, claves de cifrado o cadenas de conexión. El playbook debe decir qué capturar y qué datos sensibles excluir.
2. Valida y clasifica sin borrar la fuente
Comprueba si la señal es auténtica, si la fuente sigue funcionando y si existe una explicación autorizada. Clasifica por impacto operativo y exposición, no solo por el nombre de una regla. Una cuenta administrativa inesperada, un cambio de privilegio o una subida de archivo ejecutable merecen un tratamiento diferente a una serie de intentos fallidos sin acceso exitoso.
La clasificación debe conservar incertidumbre. Usa estados como evento explicado, incidente probable, incidente confirmado y datos insuficientes. «Datos insuficientes» obliga a seguir investigando; no equivale a «sin incidente».
3. Delimita el alcance en toda la cartera
No cierres el análisis en la primera web afectada. Busca el mismo usuario, IP, integración, proveedor, plugin, credencial o patrón temporal en los sitios que comparten tecnología o acceso. Define un denominador: webs revisadas, webs pendientes y webs sin telemetría. Si se han comprobado 24 de 27 sitios, el alcance conocido es 24; los otros tres mantienen cobertura desconocida.
Esta fase convierte una respuesta local en una decisión de cartera. Un indicador repetido en varios clientes puede revelar una cuenta compartida, una integración común o una campaña más amplia. La ausencia de coincidencias solo es significativa donde la observabilidad está confirmada.
4. Elige una contención proporcional y reversible
| Situación | Contención inicial posible | Antes de ejecutar |
|---|---|---|
| Cuenta administrativa no reconocida | Suspender sesión y acceso, preservar usuario y actividad. | Confirmar propietario, conservar registros y evitar borrar evidencia. |
| Credencial compartida o expuesta | Rotar la credencial y revocar sesiones relacionadas. | Inventariar automatizaciones que dependen de ella y preparar reversión. |
| Archivo o cambio sospechoso | Aislar el sitio o limitar la ruta afectada. | Guardar copia del artefacto, hash, marcas de tiempo y ruta observada. |
| Explotación en curso | Bloquear el vector, reducir exposición o pausar el servicio. | Acordar impacto, autoridad para interrumpir y canal con el cliente. |
| Telemetría ausente | Tratar la cobertura como desconocida. | Verificar el recorrido completo de la señal antes de declarar calma. |
Criterio editorial: la acción más rápida no siempre es la más segura. Borrar una cuenta, reinstalar todo o restaurar de inmediato puede ocultar el alcance y eliminar datos útiles. Prioriza medidas reversibles mientras el servicio y el riesgo lo permitan; escala a interrupciones mayores cuando el impacto probable lo justifique.
5. Erradica la causa observada, no solo el síntoma
Eliminar un archivo malicioso o cambiar una contraseña puede ser necesario, pero no demuestra por qué apareció ni qué otras puertas siguen abiertas. Revisa accesos administrativos, sesiones, contraseñas de aplicación, tareas programadas, reglas del servidor, usuarios del hosting, integraciones y componentes modificados. Documenta qué se cambió y qué sigue sin poder comprobarse.
La guía oficial de WordPress para sitios hackeados recomienda adoptar un enfoque pragmático, identificar los síntomas, documentar lo observado, restablecer accesos y planificar copias. También advierte que sustituir archivos existentes no elimina necesariamente archivos nuevos introducidos por un atacante. Esa limitación debe aparecer en el playbook: «reinstalado» no significa automáticamente «limpio».
6. Recupera con una prueba, no con una suposición
Antes de restaurar, identifica la fecha del backup, su relación con la ventana del incidente y qué incluye: base de datos, archivos, configuración y contenido subido. La documentación de WordPress recuerda que el sitio combina base de datos y archivos, y recomienda tratarlos como un conjunto coherente. Una copia disponible pero no probada es una opción de recuperación, no una garantía.
Después de recuperar, valida funciones críticas, acceso legítimo, integraciones, eventos de seguridad y envío de señales. Comprueba que el vector observado ya no funciona y que no aparecen indicadores equivalentes en otra parte. Guarda el resultado de la prueba, no solo la hora de la restauración.
7. Comunica y cierra con riesgo residual
La comunicación al cliente debe separar hechos, acciones y dudas: qué se observó, qué impacto está confirmado, qué se hizo, qué pruebas pasaron y qué sigue abierto. Evita fórmulas absolutas como «todo seguro» si no existe evidencia suficiente.
El cierre mínimo debería contener: alcance revisado, línea temporal, evidencia preservada, decisiones, cambios, pruebas de recuperación, responsables, sitios sin cobertura y riesgo residual. Si quedan credenciales por rotar o webs sin revisar, el caso puede pasar de emergencia a seguimiento, pero no desaparecer del registro.
Matriz de autoridad: quién puede hacer qué
| Acción | Ejecutor habitual | Aprobación previa | Evidencia de salida |
|---|---|---|---|
| Bloquear una IP maliciosa | Operador de seguridad | Preautorizada si la regla está acordada. | Regla activa, alcance y caducidad. |
| Suspender un administrador | Responsable técnico | Propietario del servicio o procedimiento de urgencia. | Sesiones revocadas y acceso legítimo verificado. |
| Poner una web en mantenimiento | Agencia/hosting | Responsable de negocio salvo amenaza inmediata acordada. | Hora, motivo, impacto y criterio de reapertura. |
| Restaurar una copia | Hosting o técnico autorizado | Coordinador del incidente y cliente según impacto. | Origen de la copia y pruebas posteriores. |
| Notificar a terceros | Responsable designado | Dirección, legal o protección de datos cuando aplique. | Mensaje, destinatario, hora y base de la comunicación. |
Los roles concretos dependen del contrato. Lo importante es que la autorización exista antes de necesitarla y que las acciones de alto impacto no queden bloqueadas por una persona ilocalizable.
Cómo probar el playbook sin provocar un incidente
- Elige tres sitios representativos: uno sencillo, uno crítico y uno con dependencias externas.
- Simula una señal inocua, por ejemplo una cuenta de prueba autorizada o un evento controlado.
- Mide recepción, asignación, acceso a evidencias, autorización y tiempo hasta la verificación.
- Introduce una condición realista: responsable ausente, dato incompleto o web que no envía señales.
- Registra qué paso dependía de memoria, una credencial desconocida o un canal informal.
- Corrige el playbook y repite hasta que otra persona pueda ejecutarlo con el mismo resultado.
Este ensayo es una propuesta editorial, no un requisito de NIST ni de WordPress. Su función es descubrir fallos de coordinación en condiciones seguras y reversibles.
Dónde encaja Vulnity
Un playbook necesita una vista común de señales, sitios y respuesta. Vulnity ayuda a centralizar la monitorización de seguridad WordPress, las alertas y acciones operativas en una cartera. Su papel es reducir dispersión y acelerar la coordinación; la agencia sigue siendo responsable de clasificar el incidente, preservar evidencia, aprobar cambios y validar la recuperación.
Limitaciones que el documento debe declarar
- Un playbook no garantiza que todos los incidentes sean detectados.
- La falta de alertas no demuestra normalidad si una web dejó de enviar datos.
- Los registros pueden ser incompletos, alterados o tener relojes desalineados.
- Una restauración correcta puede reintroducir una persistencia anterior si la copia ya estaba afectada.
- La respuesta técnica no sustituye la evaluación contractual, legal o de protección de datos.
- Vulnity no detecta CVEs ni identifica plugins, temas o versiones de WordPress vulnerables.
- Vulnity tampoco sustituye un WAF, escáner de malware, backup probado, proveedor de identidad, hosting seguro o análisis forense.
Fuentes y criterio editorial
- Evidencia primaria: NIST SP 800-61 Rev. 3 integra la respuesta a incidentes en la gestión del riesgo y cubre preparación, detección, respuesta y recuperación.
- Evidencia primaria: la Logging Cheat Sheet de OWASP documenta el contexto de evento, la protección de datos sensibles, la correlación y la integración de la monitorización con la respuesta.
- Evidencia primaria: la guía oficial FAQ My site was hacked recomienda identificar síntomas, documentar, recuperar accesos y no confiar en sobrescribir archivos como limpieza completa.
- Evidencia primaria: la documentación oficial de copias de seguridad de WordPress distingue base de datos y archivos y recomienda tratarlos como un conjunto de recuperación.
- Propuesta editorial: los ocho campos, las siete fases, la matriz de autoridad y el ensayo de tres sitios son un modelo adaptable para agencias; no son umbrales obligatorios de NIST, OWASP o WordPress.
Continuar el flujo
Este playbook funciona mejor si se conecta con tres controles ya definidos: tiempos de respuesta por prioridad, cierre de alertas con evidencia y detección de huecos de monitorización.
Si gestionas varios WordPress, prueba Vulnity para centralizar señales y coordinar una respuesta operativa más consistente. La herramienta aporta contexto; el playbook define decisiones, responsables y pruebas.
Sobre Vulnity
Mantener WordPress seguro requiere visibilidad operativa continua. Vulnity ayuda a monitorizar actividad sospechosa, alertar de cambios relevantes y conservar evidencias de respuesta.